Kategorie: Social Media

  • KI-Texte erkennen: 13.000 KI-Schreibmuster zeigen nicht, wer einen Text verfasst hat – Unternehmen brauchen Governance statt Detektor-Roulette

    KI-Texte erkennen: 13.000 KI-Schreibmuster zeigen nicht, wer einen Text verfasst hat – Unternehmen brauchen Governance statt Detektor-Roulette

    Das Wichtigste in Kürze

    Graphite hat in 10.000 menschlichen und 90.000 KI-generierten Artikeln 12.877 Wörter, Phrasen und Satzmuster gefunden, die mindestens doppelt so häufig in KI-Texten vorkamen.
    65 Prozent dieser Merkmale waren nur einer Modellfamilie zuzuordnen. Selbst aufeinanderfolgende Modellversionen teilten große Teile ihrer Auffälligkeiten nicht; bekannte Signale verschwanden, während neue entstanden.
    Beim von Gizmodo hervorgehobenen Claude Opus 5.5 erschien „this matters“ 116-mal häufiger als im menschlichen Vergleichskorpus.

    Die Managementbotschaft lautet deshalb nicht:

    „Jetzt können wir KI-Texte sicher erkennen.“

    Das Gegenteil ist der Fall.
    Stilmerkmale sind statistische Hinweise, aber kein Herkunftsnachweis. Professionell redigierte, nicht-muttersprachliche oder stark standardisierte Texte können ähnlich wirken, während überarbeitete KI-Texte Erkennungssysteme umgehen.
    Neuere Untersuchungen zeigen je nach Detektor und Textart erhebliche Unterschiede bis hin zu extremen Fehlalarmquoten.

    Unternehmen sollten daher nicht in Detektor-Roulette investieren, sondern in nachvollziehbare Redaktionsprozesse: freigegebene Werkzeuge, dokumentierte Entstehung, fachliche Prüfung, klare Verantwortlichkeit und risikobasierte Kennzeichnung. Qualität und Rechenschaftspflicht sind belastbarer als die Jagd nach verdächtigen Formulierungen.

    KI-Texte erkennen: Warum Stilmerkmale kein Beweis sind

    KI-Texte an einzelnen Wörtern oder Satzzeichen erkennen zu wollen, ist ein Managementfehler mit Ansage. Sprachmodelle verändern ihren Stil mit jeder Version, Menschen schreiben häufig formelhaft und redigierte Texte bewegen sich zwischen beiden Welten. Wer daraus eine sichere Urheberschaft ableitet, verwechselt Statistik mit Beweisführung.

    Eine neue Untersuchung zeigt das Problem in bemerkenswerter Größenordnung. In 10.000 menschlichen und 90.000 KI-generierten Webartikeln fanden die Analysten 12.877 sprachliche Muster, die bei mindestens einem Modell deutlich häufiger vorkamen. Dazu gehören nicht nur bekannte Wörter oder der Gedankenstrich, sondern Übergänge, Kontrastformulierungen, wertende Adjektive und wiederkehrende Satzrahmen.

    Für Unternehmen ist die entscheidende Frage deshalb nicht, ob ein Text „nach KI klingt“. Entscheidend ist, ob seine Aussagen stimmen, seine Entstehung nachvollziehbar ist und eine verantwortliche Person die Veröffentlichung freigegeben hat. Genau dort trennt sich produktive KI-Nutzung von billigem Content-Automatismus.
    Redaktionsteam prüft gemeinsam einen KI-unterstützten Fachartikel auf zwei Monitoren.

    1. Sprachmodelle verraten Muster, aber nicht zuverlässig ihre Herkunft

    Die Studie belegt messbare Stilunterschiede, aber keinen universellen KI-Fingerabdruck.
    Als „Tell“ galt ein Wort, eine Phrase oder ein Satzmuster, das mindestens doppelt so häufig im KI-Korpus vorkam wie in menschlichen Artikeln.

    Diese Definition beschreibt eine statistische Überrepräsentation. Sie sagt nicht, dass jeder Text mit diesem Merkmal von einer Maschine stammt.

    Das Studiendesign ist solide genug, um Trends sichtbar zu machen. Die Forscher nutzten menschliche Webartikel aus der Zeit vor dem öffentlichen Start von ChatGPT, fassten sie zusammen und ließen neun Modelle daraus neue Artikel zu denselben Themen erzeugen.
    Dadurch blieben die Themen vergleichbar, ohne dass die Modelle die Originaltexte einfach kopieren sollten.

    Die Grenzen sind ebenso wichtig wie die Ergebnisse.
    Untersucht wurden Webartikel, nicht E-Mails, Verträge, Geschäftsberichte oder Chatverläufe.

    Alle Modelle erhielten denselben Prompt. Ein anderer Schreibauftrag, eine eigene Stilvorlage oder menschliche Nachbearbeitung kann die beobachteten Merkmale deutlich verändern.

    Modellfamilien entwickeln zudem eigene Gewohnheiten. Claude neigt in der Untersuchung stärker zu Superlativen und Aussagen darüber, warum etwas wichtig sei.

    GPT-Modelle formulieren häufiger über Abgrenzungen und beschreiben, was etwas nicht ist.

    Gemini verwendet eher formale Übergänge und Verstärker.

    Das ist für Qualitätskontrollen interessant, aber als Beweismittel untauglich.

    Bekannte Auffälligkeiten verlieren außerdem schnell ihren Wert. Der Gedankenstrich galt lange als vermeintliches KI-Signal. Neuere Modelle verwenden ihn teilweise seltener als Menschen oder reduzieren ihn zwischen zwei Versionen drastisch.

    Wer Redaktionen anweist, bestimmte Satzzeichen zu vermeiden, produziert deshalb keinen menschlicheren Text, sondern nur eine neue Schablone.

    Der eigentliche Qualitätsunterschied liegt nicht in einzelnen Vokabeln. Menschliche Texte enthalten häufiger persönliche Erfahrungen, informelle Nebenbemerkungen, echte Positionen und ungleichmäßige Satzrhythmen.

    Diese Merkmale lassen sich jedoch imitieren. Glaubwürdigkeit entsteht erst, wenn der Autor eigene Beobachtungen, überprüfbare Fakten und eine verantwortete Schlussfolgerung einbringt.

    2. Der wirtschaftliche Hebel liegt im Redaktionsprozess, nicht im Detektor

    KI-Detektoren lösen das wirtschaftliche Problem nicht, weil ihre Treffer zusätzliche Prüfprozesse auslösen.

    Zu den direkten Kosten gehören Lizenzen, Schnittstellen, Schulungen und gegebenenfalls Token-Verbrauch.

    Schwerer wiegen die indirekten Kosten: Diskussionen über zweifelhafte Scores, unnötige Überarbeitungen und Fehlentscheidungen gegenüber Mitarbeitern oder Dienstleistern.

    Der Business Case für generative KI entsteht an anderer Stelle. Ein gutes System verkürzt Recherche, Strukturierung und erste Entwürfe.

    Der Mensch investiert die gewonnene Zeit in Faktenprüfung, fachliche Zuspitzung, Quellenbewertung und verständliche Sprache.

    Werden diese Aufgaben nur durch schnelle Textproduktion ersetzt, steigt zwar der Output, aber nicht zwingend der Wert.

    Beispielszenario für ein mittelständisches Unternehmen:

    Die folgenden Werte sind Annahmen, keine allgemeingültigen Benchmarks.

    Ein Kommunikationsteam erstellt 40 Fachbeiträge pro Monat. Ohne Assistenz fallen im Durchschnitt fünf Arbeitsstunden je Beitrag an; mit KI-gestütztem Entwurf und verbindlicher Prüfung sinkt der Aufwand auf dreieinhalb Stunden.

    Bei angenommenen internen Vollkosten von 75 Euro pro Stunde werden monatlich 60 Stunden beziehungsweise 4.500 Euro frei.

    Dem stehen beispielhaft 1.000 Euro für Werkzeuge, Governance, Stichproben und Schulung gegenüber. Der rechnerische monatliche Nettoeffekt beträgt 3.500 Euro, sofern Qualität, Reichweite und Korrekturaufwand mindestens stabil bleiben.

    Ein Detektor kann diesen Nutzen sogar reduzieren. Wenn 20 Prozent der Beiträge wegen eines auffälligen Scores in eine zusätzliche einstündige Prüfung gehen, entstehen bei denselben Vollkosten weitere 600 Euro pro Monat.

    Noch nicht eingerechnet sind Fehlalarme, Eskalationen und die Gefahr, guten menschlichen Text an ein vermeintlich maschinensicheres Mittelmaß anzupassen.

    Fachbegriff im Klartext: Provenienz

    Provenienz beschreibt die nachvollziehbare Herkunft und Bearbeitungsgeschichte eines Inhalts. In der Lieferkette entspricht sie einem Warenbegleitschein: Er zeigt, woher ein Produkt kommt, welche Stationen es durchlaufen hat und wer die Verantwortung übernommen hat. Ein Stildetektor betrachtet dagegen nur die Verpackung und versucht daraus den Hersteller zu erraten.

    3. Governance muss Verantwortung sichern, nicht Schreibstile überwachen

    Das größte Betriebsrisiko ist nicht ein verräterisches Wort, sondern unkontrollierte Veröffentlichung.

    Wenn Mitarbeiter vertrauliche Informationen in nicht freigegebene Dienste eingeben, Quellen ungeprüft übernehmen oder falsche Aussagen publizieren, hilft keine nachträgliche Stilanalyse. Unternehmen brauchen deshalb Regeln für Datenklassen, erlaubte Werkzeuge, Prüfpflichten und Freigaben.

    Vendor Lock-in beginnt oft unscheinbar. Prompts, Stilrichtlinien, Wissensbestände und Automationen werden auf die Eigenheiten eines einzelnen Modells zugeschnitten.

    Ein Anbieterwechsel verursacht dann nicht nur technische Arbeit, sondern verändert Ton, Qualität und Prozesslogik.

    Abstraktionsschichten, exportierbare Prompt-Bibliotheken und modellunabhängige Qualitätstests senken diese Abhängigkeit.

    Datensouveränität verlangt eine klare Grenze zwischen öffentlichem Material und geschützten Informationen.

    Personenbezogene Daten, Geschäftsgeheimnisse, Vertragsinhalte oder interne Strategiepapiere gehören nur in Systeme mit geprüften Verträgen, passender Datenverarbeitung und belastbaren Lösch- sowie Sicherheitsregeln.

    Für sensible Anwendungsfälle kann eine abgeschottete Unternehmensumgebung oder ein lokal betriebenes Modell sinnvoller sein als ein öffentlicher Dienst.

    Der EU AI Act verschiebt den Fokus zusätzlich in Richtung Transparenz und Verantwortlichkeit. Für bestimmte KI-generierte oder manipulierte Inhalte gelten Kennzeichnungs- und Offenlegungspflichten.

    Bei Texten zu Themen öffentlichen Interesses spielt die menschliche redaktionelle Kontrolle eine zentrale Rolle. Eine pauschale Kennzeichnung jedes KI-unterstützten Satzes ist daraus ebenso wenig abzuleiten wie eine pauschale Befreiung.

    Unternehmen sollten die Kennzeichnungsentscheidung daher dokumentieren. Relevant sind Zweck, Zielgruppe, Umfang der maschinellen Erzeugung, menschliche Prüfung und redaktionelle Verantwortung.

    Eine Rechtsprüfung bleibt bei Grenzfällen unverzichtbar, besonders bei öffentlicher Kommunikation, regulierten Branchen und personenbezogenen Inhalten.
    Vier Arbeitsstationen zeigen den kontrollierten Weg vom KI-Entwurf bis zur Freigabe.

    4. Gute KI-Nutzung verändert Rollen statt nur Schreibgeschwindigkeit

    Generative KI verschiebt Arbeit vom ersten Entwurf zur Bewertung. Junior-Mitarbeiter erstellen schneller brauchbare Rohfassungen, lernen dabei aber weniger durch eigenes Ringen mit Struktur und Argumentation.

    Ohne bewusstes Training entsteht ein Senioritätsproblem: Die Organisation braucht mehr Urteilskraft, baut sie aber im Nachwuchs nicht systematisch auf.

    Führungskräfte müssen deshalb Lernarbeit im Prozess erhalten. Junioren sollten Quellen prüfen, Gegenargumente formulieren und begründen, warum eine Passage übernommen oder verworfen wurde.

    Senioren kontrollieren nicht jedes Komma, sondern vermitteln Kriterien für Relevanz, Evidenz, Risiko und Tonalität.

    Auch Leistungskennzahlen müssen sich ändern. Die Anzahl veröffentlichter Texte misst Aktivität, nicht Wirkung.

    Sinnvoller sind fachliche Korrekturen pro Entwurf, Durchlaufzeit bis zur Freigabe, Anteil nachweisbarer Quellen, notwendige Nacharbeiten sowie die tatsächliche Nutzung durch Vertrieb, Service oder Kunden.

    Change Management darf nicht als Tool-Schulung enden.

    Mitarbeiter müssen wissen, welche Aufgaben sie delegieren dürfen, wo eigenes Urteil zwingend ist und wie Fehler eskaliert werden.

    Wer nur Prompt-Techniken lehrt, beschleunigt im Zweifel genau die Prozesse, die vorher schon schlecht waren.

    5. Entscheider brauchen drei Phasen statt eines weiteren KI-Tools

    Phase 1: Bestandsaufnahme und Governance-Framework

    Erfassen Sie zunächst, wo generative KI bereits eingesetzt wird. Dokumentieren Sie Werkzeuge, Datentypen, Zielgruppen, Veröffentlichungswege und Verantwortliche.

    Definieren Sie anschließend verbindliche Regeln für zulässige Daten, menschliche Prüfung, Quellenkontrolle, Kennzeichnung, Aufbewahrung und Eskalation.

    Phase 2: Pilotierung und isolierte MVP-Entwicklung

    Wählen Sie einen klar begrenzten Prozess mit messbarem Aufwand und überschaubarem Risiko.

    Ein geeigneter Pilot ist beispielsweise die Erstellung interner Wissensartikel aus bereits freigegebenen Quellen. Messen Sie Ausgangsaufwand, Nachbearbeitung, Fehlerrate und Durchlaufzeit, statt nur subjektive Textqualität zu bewerten.

    Verzichten Sie im Pilot auf eine tiefe Bindung an ein einzelnes Modell. Halten Sie Prompts, Prüfkriterien und Wissensquellen getrennt vom Anbieter. Testen Sie mindestens eine Alternative, damit Leistungsunterschiede und Wechselkosten sichtbar werden.

    Phase 3: Rollout, Monitoring und Mitarbeiter-Befähigung

    Skalieren Sie nur Prozesse, deren Nutzen nach der vollständigen Qualitätsprüfung positiv bleibt. Etablieren Sie Stichproben, Versionsprotokolle, Vorfallmanagement und regelmäßige Neubewertungen der Modelle.

    Schulen Sie Mitarbeiter rollenbezogen:
    Autoren brauchen andere Kompetenzen als Freigabeverantwortliche, Datenschutzbeauftragte oder Administratoren.

    Detektoren dürfen höchstens ein schwaches Warnsignal liefern. Eine Auffälligkeit kann eine manuelle Prüfung auslösen, aber niemals allein eine Sanktion, Ablehnung oder öffentliche Anschuldigung begründen.

    Für belastbare Entscheidungen zählen Entstehungsnachweise, Versionen, Quellen und die fachliche Befragung des Verantwortlichen.

    Fazit: Am Montag braucht es einen Prozessverantwortlichen, keinen Sprachdetektiv

    Die Jagd nach KI-Wörtern ist operativ verführerisch und strategisch unbrauchbar. Sie erzeugt den Eindruck von Kontrolle, obwohl Modelle, Prompts und menschliche Bearbeitung die Signale laufend verändern. Unternehmen sollten nicht versuchen, KI aus Texten herauszuriechen, sondern Qualität und Herkunft prüfbar machen.

    Der CEO sollte am Montag um 9:00 Uhr einen verantwortlichen Eigentümer für KI-gestützte Veröffentlichungsprozesse benennen.

    Dessen erster Auftrag könnte lauten:

    Bitte dokumentiere innerhalb von 30 Tagen die vorhandenen Werkzeuge, Datenflüsse, Freigaben und Kennzeichnungsentscheidungen und starte einen begrenzten Pilot mit messbaren Qualitäts- und Kostenzielen.

    Alles andere ist Aktionismus mit Softwarelizenz.

    5. FAQ

    Kann man KI-generierte Texte an bestimmten Wörtern sicher erkennen?

    Nein. Häufige Formulierungen können statistische Hinweise liefern, beweisen aber nicht die Herkunft eines einzelnen Textes. Graphite fand zudem, dass 65 Prozent der untersuchten Auffälligkeiten nur bei jeweils einer Modellfamilie vorkamen und sich Merkmale zwischen Modellversionen stark verschoben.

    Für Sanktionen oder verbindliche Entscheidungen sind solche Hinweise daher ungeeignet.

    Wie sollten Unternehmen KI-unterstützte Texte zuverlässig prüfen?

    Unternehmen sollten Herkunft, Quellen, Bearbeitungsschritte und Freigabe dokumentieren. Fachliche Richtigkeit, Datenschutz, Urheberrechte, Geschäftsgeheimnisse und Tonalität müssen risikobasiert geprüft werden.

    Detektoren können allenfalls eine zusätzliche manuelle Prüfung anstoßen, sollten aber nie alleinige Entscheidungsgrundlage sein; auch aktuelle Forschung warnt vor ihrem Einsatz als einzigem Beweismittel.

    Müssen Unternehmen KI-generierte Texte nach dem EU AI Act kennzeichnen?

    Nicht jeder KI-unterstützte Geschäftstext ist automatisch öffentlich zu kennzeichnen. Artikel 50 erfasst unter anderem KI-generierte oder manipulierte Texte, die die Öffentlichkeit über Angelegenheiten von öffentlichem Interesse informieren sollen; eine Ausnahme kann bei menschlicher Prüfung, redaktioneller Kontrolle und klarer redaktioneller Verantwortung greifen. Unternehmen sollten Zweck, Umfang der KI-Nutzung und Freigabe dokumentieren und Grenzfälle rechtlich prüfen lassen.

    Key Takeaways

    • Strategischer Kernpunkt: Sprachliche Auffälligkeiten sind Indizien, keine belastbare Attribution; Unternehmen müssen Textqualität und Verantwortlichkeit statt vermeintliche „Menschlichkeit“ steuern.
    • Technologischer Fakt: Graphite fand 12.877 mindestens doppelt überrepräsentierte Muster; 65 Prozent waren auf jeweils eine Modellfamilie begrenzt.graphite
    • Finanzieller Aspekt: Der größte Hebel liegt nicht im Kauf weiterer Detektoren, sondern in weniger Nacharbeit, schnelleren Freigaben und der Vermeidung von Fehlentscheidungen.
    • Compliance-Aspekt: Artikel 50 des EU AI Act verlangt seit 2. August 2026 für bestimmte KI-Inhalte Transparenz; redaktionell geprüfte Texte unter verantwortlicher menschlicher Kontrolle können von der Offenlegungspflicht für Texte zu Themen öffentlichen Interesses ausgenommen sein.digital-strategy.ec.europa
    • Management-Konsequenz: Jede Veröffentlichung braucht einen dokumentierten Eigentümer, eine fachliche Prüfung und eine definierte Kennzeichnungsentscheidung.

    #KünstlicheIntelligenz #AIGovernance #ContentStrategie #EUAIAct #DigitalTransformation


  • Social-Media-Formatierung: Was wirklich Reichweite bringt

    Social-Media-Formatierung: Was wirklich Reichweite bringt

    Absätze bringen 1,6x mehr Reichweite – Unicode-Fettschrift kann sie halbieren. Meine Formatierungs-Fakten für Entscheider.


    Wer seinen LinkedIn-Post mit Unicode-Fettschrift vollpflastert, verliert Reichweite – während dieselbe Zeit, in Absatzstruktur investiert, sie fast verdoppeln kann.

    Das ist keine Stilfrage, sondern eine messbare Konsequenz davon, wie Plattform-Algorithmen und Sonderzeichen tatsächlich funktionieren.

    Ich zeige dir in diesem Artikel, wo genau der Unterschied zwischen Reichweiten-Gewinn und Reichweiten-Verlust liegt – und wo du das gleich selbst ausprobieren kannst.

    Für mich ist das jetzt geschäftskritisch, weil Social Media der günstigste Vertriebskanal bleibt, den viele meiner Kunden haben.

    Jeder Prozentpunkt Reichweite, der durch falsche Formatierung verschenkt wird, ist verlorenes Budget – ohne dass es in irgendeiner Rechnung auftaucht.

    Ich sehe das in meinen Projekten immer wieder:

    Mitarbeitende kopieren fette Unicode-Überschriften aus irgendwelchen Online-Generatoren, weil es „professioneller aussieht“.

    Die Realität: Genau das kann die Sichtbarkeit senken, die der Post eigentlich erzeugen sollte.


    Führungskraft vergleicht zwei Social-Media-Post-Layouts auf Smartphone-Bildschirmen

    Warum Absätze mehr Reichweite bringen als jede Schriftart

    Die wichtigste Erkenntnis vorweg: Nicht die Schriftart entscheidet über Sichtbarkeit, sondern die Lesbarkeit.

    Auswertungen über mehrere hunderttausend LinkedIn-Posts zeigen, dass Beiträge mit zwanzig oder mehr kurzen Absätzen etwa den 1,13-fachen Reichweiten- und den 1,23-fachen Engagement-Wert des Durchschnitts erreichen.

    Beiträge mit fünf oder weniger Absätzen fallen dagegen auf rund 0,70 beziehungsweise 0,73 zurück – bei identischem Textinhalt.

    Der Unterschied zwischen bestem und schlechtestem Fall liegt damit bei etwa dem 1,6-fachen der Reichweite, ausschließlich durch Absatzstruktur.

    Der Mechanismus dahinter ist simpel und hat nichts mit Geschmack zu tun. Auf dem Smartphone-Bildschirm sieht ein dichter Textblock aus wie eine Wand, die niemand freiwillig betreten möchte.

    Ein Leser entscheidet innerhalb von Sekunden, ob er weiterliest oder scrollt – und diese Entscheidung fällt visuell, bevor der erste Satz überhaupt inhaltlich verarbeitet wird.

    Kurze Absätze mit klaren Zeilenumbrüchen geben dem Auge Ruhepunkte und verlängern die tatsächliche Lesezeit, die sogenannte Dwell Time.

    Diese Dwell Time ist der eigentliche Hebel im Algorithmus, nicht die Optik selbst.

    Plattformen messen, wie lange jemand bei einem Beitrag verweilt, wie schnell Reaktionen kommen und wie tief Kommentare gehen.

    Ein gut strukturierter Post wird vollständig gelesen statt nur angerissen – und genau dieses Leseverhalten meldet der Algorithmus als Relevanzsignal weiter.

    Auch die Textlänge folgt diesem Muster, nicht umgekehrt.

    Die Engagement-Rate steigt mit zunehmender Zeichenzahl bis zu einem Bereich von etwa 2.000 bis 2.500 Zeichen, wo der Median bei rund 2,67 Prozent liegt – deutlich höher als bei sehr kurzen Posts unter 400 Zeichen, die nur etwa 2,10 Prozent erreichen.

    Entscheidend ist dabei: Ein längerer Post funktioniert nur, wenn er durch saubere Absätze lesbar bleibt.

    Warum Unicode-Fettschrift die Suche blind macht

    Was die meisten Nutzer nicht wissen: Fettschrift auf LinkedIn, Facebook, Instagram und X existiert technisch gar nicht als Formatierung.

    Keine dieser Plattformen bietet im normalen Post-Editor einen echten Fett-Button.

    Was aussieht wie fetter Text, ist in Wirklichkeit eine komplette Zeichenersetzung – jeder Buchstabe wird durch ein optisch ähnliches, aber technisch völlig anderes Unicode-Zeichen aus einem mathematischen Zeichensatz ausgetauscht.

    Diese technische Realität hat eine Konsequenz, die viele Unternehmen teuer zu stehen kommt: Die Suchfunktion von LinkedIn und ähnlichen Plattformen erkennt diese Sonderzeichen nicht als reguläre Buchstaben.

    Ein Firmenname, ein Hashtag oder ein Keyword, das in Unicode-Fettschrift gesetzt wurde, taucht in der Suche schlicht nicht auf.

    Dasselbe Problem betrifft Screenreader, die für barrierefreien Zugang zuständig sind.

    Zur Reichweite kommt noch ein zweites, größeres Problem hinzu. Beobachtungen aus der Creator-Community zeigen, dass reine Textposts im Schnitt 30 bis 60 Prozent mehr Impressions erzielen als Posts mit mehreren Unicode-Fett-Überschriften.

    Diese Zahl stammt nicht aus einer kontrollierten wissenschaftlichen Studie, sondern aus aggregierten Praxisbeobachtungen mehrerer Jahre – sie sollte deshalb als belastbarer Trend gelesen werden, nicht als exakter Laborwert.

    Fachbegriff im Klartext: Unicode-Zeichenersetzung

    Stell dir vor, du schreibst einen Brief mit einem normalen Kugelschreiber und einen zweiten Brief mit einem Stempel, der optisch fast identisch aussehende, aber im Alphabet nicht existierende Symbole erzeugt. Für das menschliche Auge sehen beide Briefe ähnlich aus. Für ein Sortiersystem, das nach dem echten Alphabet sucht, ist der zweite Brief unlesbar. Genau das passiert bei Unicode-Sonderzeichen: Menschen erkennen die Absicht, Maschinen oft nicht.

    Was auf Social Media technisch überhaupt möglich ist

    Weil es kein echtes Rich-Text-Format im Feed gibt, sind alle sichtbaren Formatierungsoptionen im Grunde Workarounds mit eigenen Grenzen.

    Es gibt keine echten Schriftgrößen oder Überschriftenebenen, weil Unicode keine Größenvarianten kennt, sondern nur unterschiedliche Stilvarianten desselben Buchstabens.

    H1 bis H3 lassen sich deshalb nur simulieren, etwa über Großschreibung und unterschiedliche Fettgrade.

    Farbige Hervorhebung ist auf diesem Weg ebenfalls nicht erreichbar, weil Farbe eine reine Darstellungseigenschaft ist.


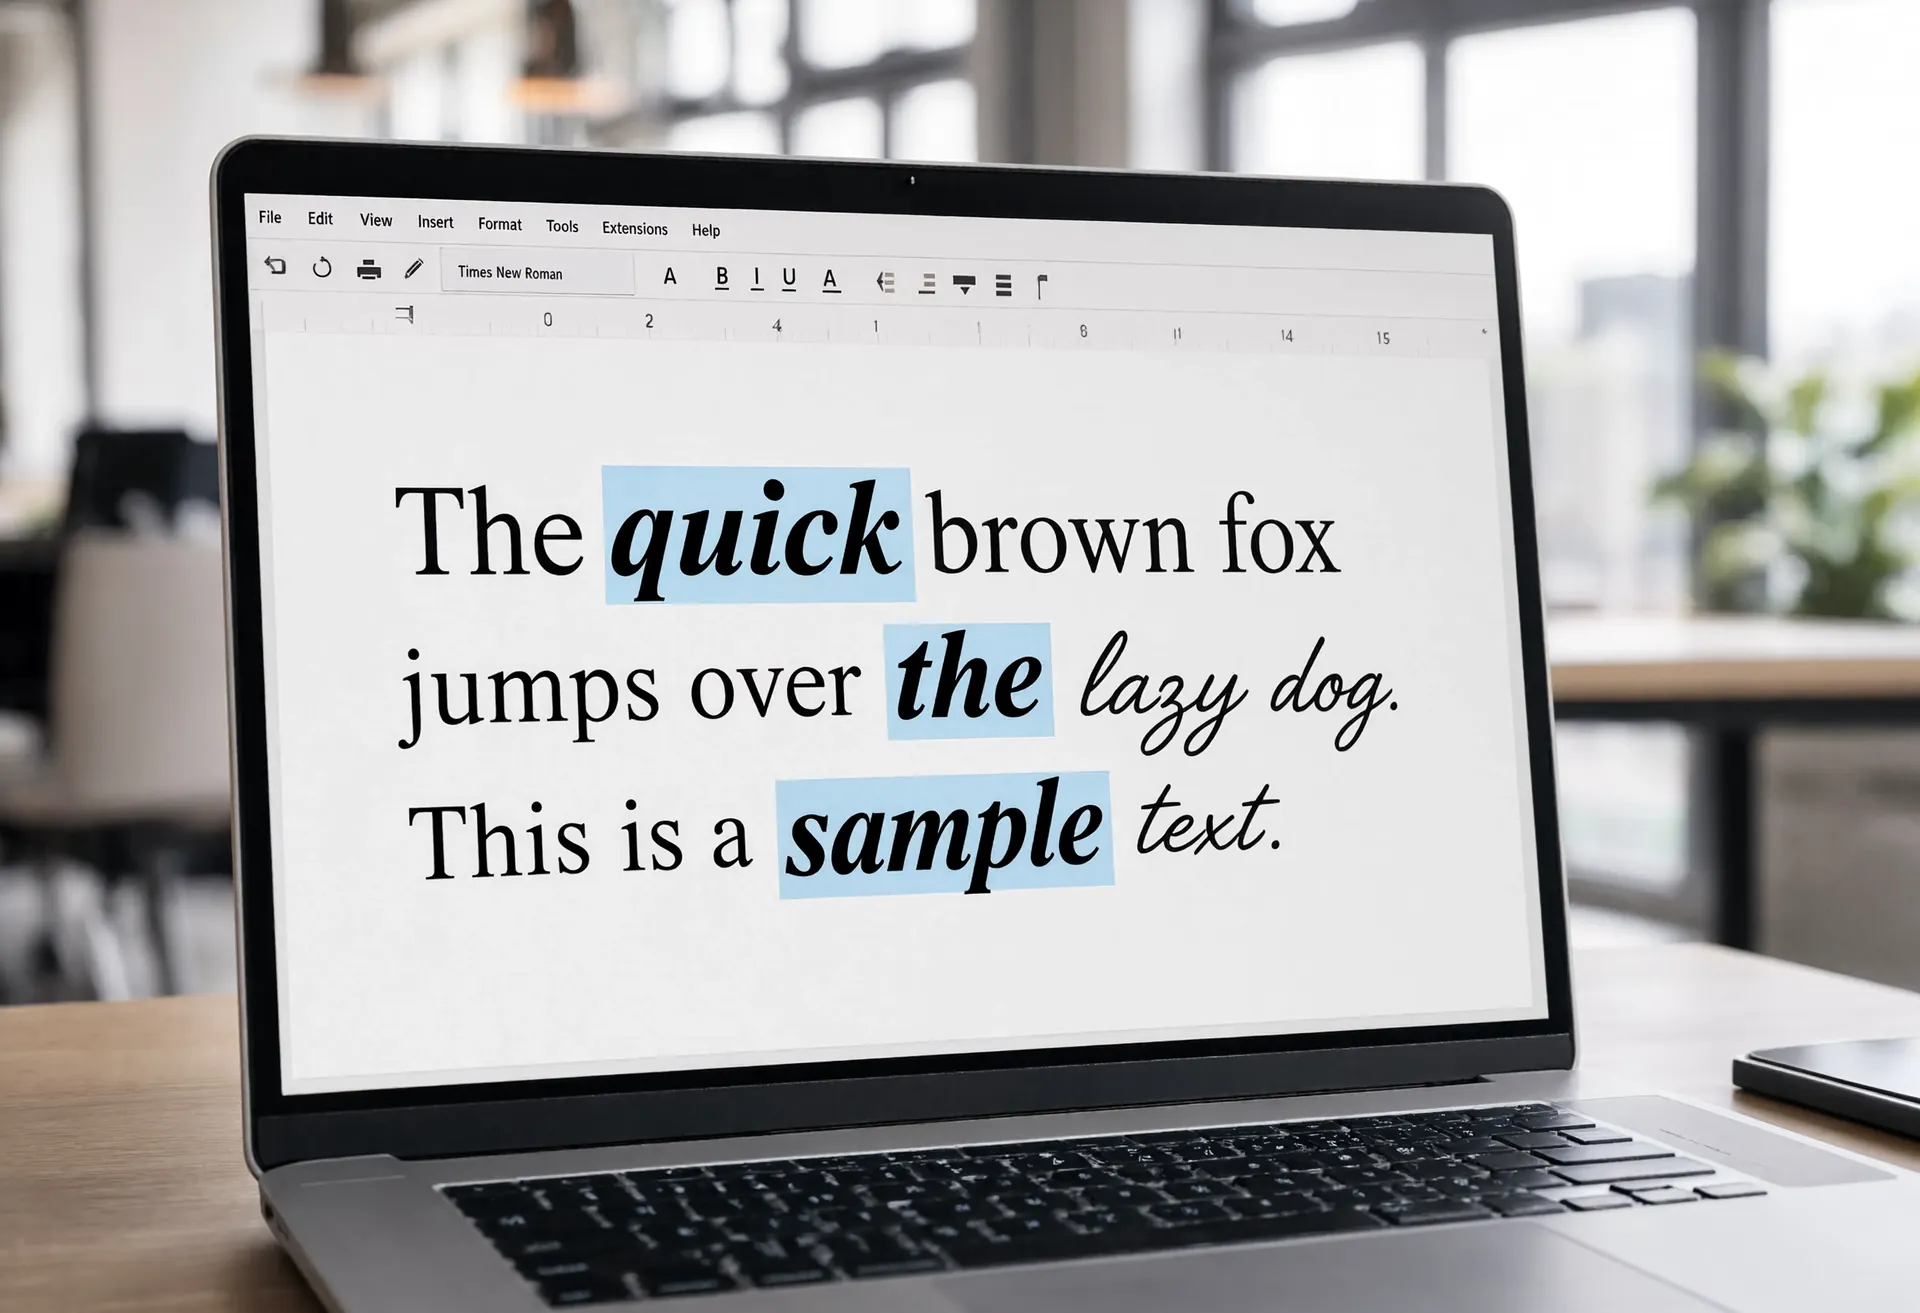
    Laptop-Bildschirm zeigt Textformatierungswerkzeug mit hervorgehobenen Wörtern

    Eine ehrliche Alternative sind Rahmen- oder Balken-Marker, die visuell an einen Textmarker erinnern.

    Auch Einrückungen werden von den meisten Plattformen beim Rendern zusammengefaltet; nur das ideographische Leerzeichen aus dem asiatischen Zeichensatz bleibt stabil und ermöglicht dadurch tatsächlich funktionierende Listen-Einrückung.

    Was tatsächlich funktioniert, ist eine kleine, disziplinierte Auswahl:

    gezielte Fett- oder Kursivhervorhebung einzelner Kernaussagen statt ganzer Absätze,

    konsequente Absatzstruktur als eigentlicher Reichweiten-Hebel,

    echte Bullet-Symbole statt improvisierter Emoji-Ketten und simulierte Überschriften nur in längeren Beiträgen.

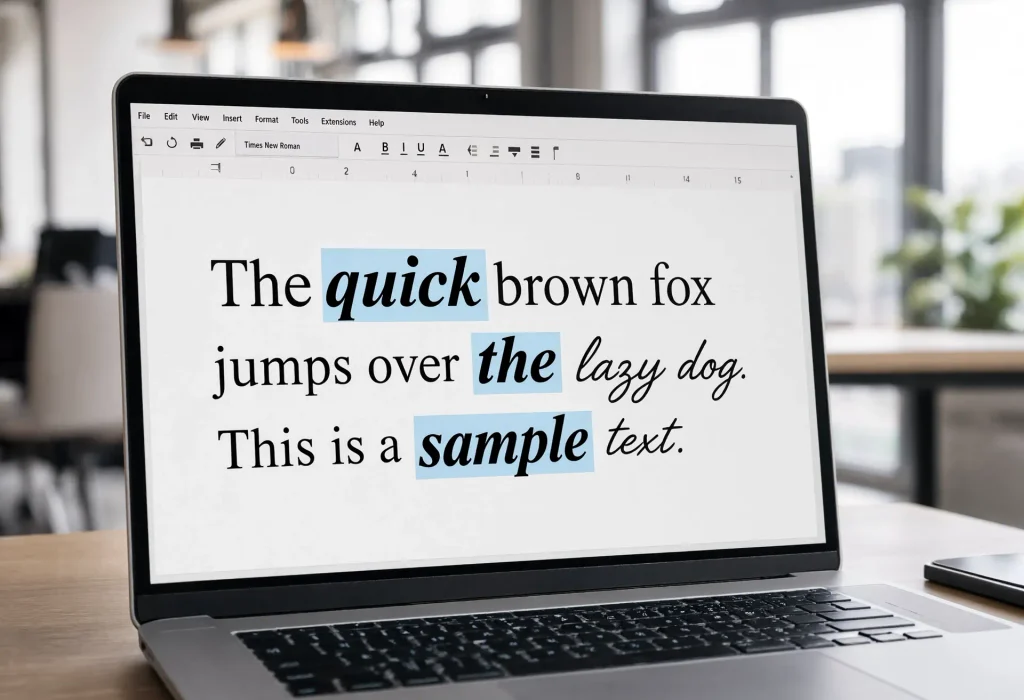
    Genau diese vier Werkzeuge habe ich in mein Tool (das findest du weiter unten) eingebaut – bewusst nicht mehr, damit du gar nicht erst in Versuchung kommst, es zu übertreiben.


    Laptop-Bildschirm zeigt Textformatierungswerkzeug mit hervorgehobenen Wörtern

    Warum mein Tool auch aus Datenschutzsicht funktioniert

    Für Legal-Tech-Kanzleien, Telekommunikationsunternehmen und generell datenschutzsensible Branchen ist ein Detail entscheidend, das auf den ersten Blick technisch klingt: Wo läuft die Textverarbeitung tatsächlich ab?

    Ich habe mein Tool bewusst so gebaut, dass die Verarbeitung ausschließlich im Browser passiert – dein Text geht nie an einen Server.

    Es gibt keinen Übertragungsweg, auf dem vertrauliche Formulierungen oder Kundendaten dein Gerät verlassen könnten.

    Diese Architektur hat eine direkte rechtliche Konsequenz:

    Wenn keine Nutzerdaten das Endgerät verlassen, entsteht kein datenschutzrechtlich relevanter Verarbeitungsvorgang im Sinne der DSGVO.

    Kein Tracking, keine Cookies, kein Speichern von Eingaben bedeuten auch, dass es schlicht keine Auftragsverarbeitung gibt, die dokumentiert werden müsste.

    Kein Login und keine Registrierung ergänzen das konsequent:

    Du öffnest die Seite, nutzt das Tool, gehst wieder – ohne eine einzige Spur zu hinterlassen.

    Warum ich dieses Tool gebaut habe – und warum es sich lohnt, die Seite zu speichern

    Ich baue solche pragmatischen Tools, weil ich sie in meinen eigenen Projekten für Kunden aus Legal Tech, Gastro und Telko ständig brauche.

    Ich wollte nicht jedes Mal einen von zwanzig fragwürdigen Online-Generatoren durchsuchen, die meine Texte irgendwo speichern und mit Werbung zupflastern.

    Also habe ich mein eigenes Tool gebaut – schnell, kostenlos, ohne Schnickschnack, und mit genau den Formatierungsoptionen, die auf Social Media wirklich funktionieren.

    Ich teile es hier, weil gute Werkzeuge meiner Meinung nach nicht hinter Paywalls gehören.

    Aber ich will ehrlich sein: Ich habe auch ein Interesse daran, dass du diese Seite wiederfindest.

    Speichere sie dir als Lesezeichen – jedes Mal, wenn du einen Post für LinkedIn, Instagram oder X vorbereitest, hast du in Sekunden das passende Werkzeug parat, ohne erneut zu suchen.

    Und wenn du das Tool nützlich findest, freue ich mich, wenn du es mit Kolleg:innen teilst, die genauso viel Zeit mit copy-paste aus zweifelhaften Generatoren verschwenden wie ich früher.

    Das ist im Übrigen auch der Grund, warum ich diesen Blog überhaupt betreibe: Ich zeige hier regelmäßig, wie ich als IT-Berater an technische Probleme herangehe – nicht mit Marketing-Floskeln, sondern mit echten Tools, echten Zahlen und ehrlichen Einschätzungen, wo eine Sache Grenzen hat. Wer das mag, findet hier künftig mehr davon.

    Probier es direkt aus: Testtext für den Formatter

    Kopiere den folgenden Text in mein Formatierungstool und probiere selbst aus, wie sich Fettschrift, Überschriften und Listen auf die Lesbarkeit auswirken. Kopiere Dir den Text und füge diesen unten in mein „Social Media Text Formatter“ Tool ein.

    Markiere dann einzelne Wörter oder Zeilen, wandle sie um, und beobachte den Unterschied zum unformatierten Original.


    Text kopieren und unten in das Tool kopieren


    Ich habe gerade herausgefunden, warum die Hälfte meiner Social-Media-Posts untergeht.

    Es liegt nicht am Inhalt. Es liegt an der Formatierung.

    Drei Dinge, die ich ab heute anders mache:

    • Kurze Absätze statt Textwände
    • Maximal eine fette Kernaussage pro Post
    • Keywords immer in normaler Schrift, sonst findet die Suche sie nicht

    Das Tool, mit dem ich das gerade getestet habe, kommt von Marc Juncke – IT-Berater aus Köln. Kostenlos, ohne Login, läuft komplett im Browser. Ich verlinke es hier: https://juncke.com/social-media-formatierung-was-wirklich-reichweite-bringt/


    Text kopieren und unten in das Tool kopieren


    Social Media Text Formatter

    Unicode-Textformatierung fuer Facebook, LinkedIn, Instagram & X – 100% im Browser, kein Login.

    So geht’s: Text einfuegen → Abschnitt/Zeilen markieren → Button klicken. Nur der markierte Teil wird umgewandelt. Hinweis: Facebook, LinkedIn & Co. unterstuetzen keine echten Ueberschriften, Farb-Textmarker oder Schriftgroessen – „H1-H3“ und „Marker“ werden hier simuliert. Die LinkedIn-Suche indexiert fett/kursiv formatierten Unicode-Text nicht als normale Buchstaben – Keywords, Hashtags und Firmennamen daher besser nicht fett setzen.

    Wenn du gerade selbst testest: Poste dein Ergebnis und markiere mich gerne. Ich bin gespannt, was ihr daraus macht.

    Sobald du dein eigenes Ergebnis hast, kannst du genau diesen Ablauf für deinen echten Post wiederholen:

    • Text schreiben,
    • im Tool strukturieren,
    • das Vorher-Nachher direkt sehen.

    Und wenn dir das einen Aha-Moment liefert, freue ich mich über einen Screenshot oder ein Tag auf deinem eigenen Kanal – das ist die beste Bestätigung, dass die Formatierungslogik in diesem Artikel tatsächlich hält, was sie verspricht.

    Was das für Prozesse und Mitarbeitende bedeutet

    Formatierungsdisziplin ist am Ende eine Frage der Organisation, nicht der Technik.

    Wenn jeder Mitarbeitende im Marketing-Team nach eigenem Geschmack Unicode-Generatoren nutzt, entsteht ein uneinheitliches Markenbild – und im schlimmsten Fall systematisch verschenkte Reichweite über Monate.

    Die Lösung ist keine komplizierte Software, sondern eine kurze, verbindliche Richtlinie:

    • maximal eine bis zwei hervorgehobene Kernaussagen pro Post,
    • klare Absatzstruktur als Standard,
    • Keywords grundsätzlich in normaler Schrift.

    Fazit: Mein Urteil als Berater

    Formatierung ist kein Marketing-Gimmick, sondern eine der wenigen Stellschrauben mit sofort messbarer Wirkung auf Social-Media-Reichweite – vorausgesetzt, man setzt sie richtig ein.

    Ich rate jedem, der das liest: Prüfe am Montagmorgen deine letzten zehn Unternehmensposts auf Absatzstruktur und Unicode-Dichte, bevor du über ein größeres Social-Media-Budget entscheidest.

    Und teste mein Tool dabei gleich mit – speichere dir die Seite, (jetzt Strg + D oder (Apfel + D wenn du am MAC sitzt) drücken) damit du sie beim nächsten Post sofort wieder findest, und wenn sie dir Zeit spart, gib sie gerne weiter.


    5. FAQ (AEO & LLM-optimiert)

    Bringt mehr Formatierung automatisch mehr Reichweite auf Social Media?


    Nein. Absatzstruktur und Zeilenumbrüche steigern die Reichweite nachweislich, während übermäßige Unicode-Fettschrift sie senken kann.

    Entscheidend ist nicht die Menge an Formatierung, sondern die richtige Balance zwischen Lesbarkeit und Sparsamkeit bei Sonderzeichen.

    Warum wird mein fett formatierter LinkedIn-Post in der Suche nicht gefunden?


    Weil Unicode-Fettschrift technisch keine echten Buchstaben verwendet, sondern optisch ähnliche Sonderzeichen aus einem anderen Zeichensatz. Die Suchindexierung von LinkedIn erkennt diese Zeichen nicht als reguläre Buchstaben und ignoriert sie entsprechend.

    Ist ein kostenloses Formatierungstool aus DSGVO-Sicht überhaupt unbedenklich?


    Das hängt vollständig von der technischen Architektur ab, nicht vom Preis. Mein Tool, das die Textverarbeitung ausschließlich im Browser des Nutzers durchführt und keine Daten an einen Server sendet, erzeugt keinen datenschutzrechtlich relevanten Verarbeitungsvorgang.


  • Bilder für Facebook und Co. kostenlos und kinderleicht mit der Web-App Landscape anpassen

    Die richtige Bildgröße für die verschiedenen Social-Media Plattformen zu finden und das Bildmaterial dann auf diese Größen zuzuschneiden ist eine notwendige, aber auch zeitaufwendige Arbeit. Aber da es im Internet ja allerhand praktische Hilfsmittel für alle Lebenslagen gibt, möchte ich Euch heute kurz die Web-App Landscape vorstellen.

    Dieses Online-Tool bringt Euer Bildmaterial mit ein paar Mausklicks in die richtige Form und erspart Euch so stundenlange Arbeit.Der ganze Spaß ist angelegt für Twitter, Facebook, Instagram, Pinterest, LinkedIn, Google+ sowie Youtube und ist kinderleicht zu bedienen.

    Die Google-Bilder-Suche ist keine legitime Quelle

    Zuerst benötigt Ihr natürlich das passende Bildmaterial, mit dem Ihr Eure Inhalte attraktiver gestalten möchtet. Falls dieses Bildmaterial nicht von Euch selbst erstellt wurde achtet bitte darauf, dass Ihr rechtlich auf der sicheren Seite seid. Verwendet bitte nur Bilder, bei denen die Frage des Urheberrechts geklärt ist. Denn neben der landläufigen Meinung ist es nämlich nicht in Ordnung, einfach die Google-Bilder-Suche anzuwerfen und anschliessend das erst beste Bild für eigene Beiträge zu verwenden. Das kann ganz schnell in sehr teuren Rechtsstreitigkeiten enden und sollte unter allen Umständen vermieden werden. Zusätzlich solltet Ihr darauf achten, dass Euer Bildmaterial in hoher Auflösung vorhanden ist und einen breiten Rahmen „überflüssiger“ Bildelemente hat. Denn im Prozess des Zuschnitts wird, wie der Name es ja schon sagt, Euer Bild beschnitten. Ich empfehle Euch da einfach mal etwas rumzuspielen, dann kriegt Ihr den passenden Dreh schon raus.

    Ein paar Klicks später sind die fertigen Bilder auf Eurem Rechner

    Wenn Ihr dann das passende Bild gefunden habt sorgt Ihr dafür, dass die Datei nicht größer als 10MB ist und geht auf die Landscape Seite.
    Dort müsst Ihr Euer Bild hochladen, einen kurzen Augenblick warten, und anschliessend werdet Ihr mit dieser Seite konfrontiert:

    Hier wählt Ihr jetzt aus, für welches der sozialen Netzwerke Euer Bildmaterial optimiert werden soll. Anschliessend könnt Ihr noch auswählen, für welche Art des Beitrages (also z.B. als Titelbild oder als Beitragsbild) Euer Bildmaterial optimiert werden soll.

    Am Ende des Prozesses wird automatisch ein Zip-Archiv mit den erstellten Bildern auf Eurem Rechner heruntergeladen, das Zip-Archiv müsst Ihr jetzt entpacken und dort sind die fertigen Bilder. Wie gesagt, es ist kinderleicht und ich wünsche Euch viel Spaß mit der gewonnenen Freizeit.

    Falls Ihr noch Fragen oder Anmerkungen habt, packt mir diese einfach in die Kommentare.

  • Wie kann ich Facebooks nervige Spiele blockieren?

    Es gibt wenige Features auf Facebook, die so polarisieren wie die Spiele-Apps. Die eine Seite liebt sie, während der anderen Seite schon beim Gedanken an eine „Spiele-Anfrage“ der Kamm schwillt. Damit Ihr jetzt aber nicht an einem Herzinfarkt sterben müsst, gibt es bei Facebook die Möglichkeit Apps (und damit auch alle zukünftigen Anfragen zu diesen Apps) zu blockieren. Das ist auch kein Hexenwerk, sondern bedarf nur einiger Klicks. (mehr …)

  • Wie lösche ich meinen Instagram Account?

    Facebook hat heute mal wieder einen Bock geschossen und macht die hauseigene Photo-Sharing-App Instagram zur größten Bild-Agentur der Welt. Ab dem 16 Januar 2013 gelten dort geänderte Nutzungsbedingungen.

    Diese sind mal ein richtiger Hammer, denn sie geben Facebook das Recht, Eure hochgeladenen Bilder werblich zu nutzen und sie auch an dritte Unternehmen zu verkaufen. Ist doch kein Problem oder? Dann gibt es halt eine zusätzliche Einahmequelle für Euch; „WEB 3.0“ mit Geld verdienen und so! Pustekuchen, um die Geschichte so richtig rund zu machen, dürfen die Eure Bilder verkaufen, ohne Euch an den Einnahmen zu beteiligen. Kein Bitte, kein Danke; einfach mal so! Glaubt Ihr nicht? Ist aber so!

    Die gesamte Geschichte könnt Ihr hier (allerdings auf Englisch) nachlesen. Um bei diesem miesem Spiel auf der sicheren Seite zu sein, bleibt Euch nur die Möglichkeit, bis zum 15.01.2013, Euer Konto bei Instagram zu kündigen. Bevor Ihr jedoch kündigt, solltet Ihr Eure Bilder von Instagram sichern. Dies könnt Ihr problemlos mit diesem Service hier machen. Anschliessend klickt Ihr bitte hier und arbeitet die Punkte 1. bis 5. durch. Viel Spaß damit.

    1.

    Instagram Startseite
    Unten links auf „Dein Konto“ klicken.


    2.

    Instagram-Einloggen
    Jetzt bitte einloggen!


    3.

    Instagram-Konto löschen
    Hier müsst Ihr jetzt unten rechts auf „Ich möchte mein Konto löschen“ klicken.


    4.

    Instagram-Konto endgültig löschen
    Hier müsst Ihr einen Grund angeben, warum Ihr das Konto löschen möchtet. Ich habe hier einfach „other Reasons“ verwendet. Das Passwort nochmal bestätigen und anschliessend bitte auf die rote Schaltfläche klicken.


    5.

    Instagram-Konto gelöscht
    Wenn Ihr das hier seht, habt Ihr alles richtig gemacht.

    Jetzt müsst Ihr nur noch die App deinstallieren und Ihr seid raus.

    Update I:

    In diversen Artikeln wird gerade betont, das dieses Vorgehen doch gar nicht so schlimm und absolut notwendig sei, um den Geschäftsbetrieb aufrechtzuerhalten. Ich zitiere hierzu einfach mal den Facebook-Post vom Rechtsanwalt Thomas Schwenke: 

    „Nachdem die Foto-App & Community Instagram im September von Facebook gekauft worden ist, passt Instagram nun die AGB an und geht dabei noch weiter, als es z.B. die Facebook-AGB tun.
    So nimmt sich Instagram z.B. das Recht heraus die Bilder und Informationen der Nutzer für Werbezwecke zu verwenden und die Daten der Nutzer an rechtlich verbundene Unternehmen „Affiliates“ ohne Zustimmung der Nutzer weiter zu geben (wozu insbesondere Facebook gehört).
    Diese AGB sind nach unseren Gesetzen schlicht rechtswidrig, da das Deutsche AGB-Recht zumindest für Verbraucher anwendbar ist und nicht durch die AGB von Instagram ausgeschlossen werden kann.
    Dass man dagegen, außer den Dienst nicht mehr zu nutzen, praktisch nichts tun kann, sollte jedem klar sein. Also „Friss oder Stirb“. Wie das Letztere geht, erklärt die Wired: http://www.wired.com/gadgetlab/2012/12/how-to-download-your-instagram-photos-and-kill-your-account/“

    Eine harmlose Änderung der AGB’s sieht für mich anders aus. Deshalb habe ich meinen Instagram-Account gelöscht.

    Update II:

    Gestern Abend hat Kevin Systrom, einer der Mitbegründer von Instagram, einen Rückzieher bei den geplanten Änderungen der Nutzungsregeln gemacht. Er lies folgendes verlauten: „Wir haben keine Absicht, Ihre Fotos zu verkaufen“! Zusätzlich entschuldigte Er sich am Dienstagabend für die unklaren Formulierungen. Auch müssten sich Nutzer keine Sorgen machen, dass ihre Bilder ungefragt in Werbeanzeigen auftauchen. 

    Das ist ja alles schön und gut. Ich stelle mir nur die Frage, weshalb die neuen Nutzungsregeln, obwohl dieses Szenario nie in Betracht gezogen wurde, dann überhaupt so „unklar“ formuliert werden mussten. Ein simpler Post und Tweet nach dem Motto: „Hallo zusammen, wir ändern unsere Nutzungsregeln, damit wir Euch ein besseres Nutzungserlebnis ermöglichen können.“ Zusätzlich einfach Formulierungen verwenden, die nicht „unklar“ sind, und das Problem kommt gar nicht erst auf. Das sollten die Jungs und Mädels von Instagram, und auch besonders die von Facebook, eigentlich selber wissen. Ich vermute mal, das Sie einfach testen wollten, wie weit Sie gehen können. Dabei sind sie darüber gestolpert, dass sich die Nutzer nicht mehr alles gefallen lassen. Vielleicht lernt ja der eine oder andere etwas daraus.

  • Warum Ihr Euer Gehirn „Online“ nicht komplett abschalten solltet!

    Vielleicht habt Ihr es ja auch schon gesehen. Amazon verschenkt 25 Euro Gutscheine an alle. Unter den Teilnehmern werden dann auch noch einige MacBooks verlost. Kostet nur einen „Gefällt mir“ Klick und einen Kommentar. Erstmal vorab: Das ist eine Falschmeldung, und alle die darauf reingefallen sind, oder dies noch vorhaben, sollten mal diesen Artikel  hier lesen!

    Auf Facebook tauchen ja permanent Meldungen von den unglaublichsten Rabatten und Gratisangeboten auf. Mal sind es kostenlose „Ray Ban Brillen“, „Adidas- Taschen“, oder wie gesagt „Amazon Gutscheine“, die, ohne große Gegenleistung, an die User verteilt werden. Die Angebote haben alle etwas gemeinsam, sie sind zu gut um wahr zu sein. Überschlagt doch einfach mal, was es kosten würde, diese Gewinne, an sagen wir mal ne Million Leute, auszuschütten.  (mehr …)